
复习
核心问题:
- 四大科学范式
- 机器学习定义(ETP)
- 机器学习的要素
Q&A
五大科学范式是什么?
机器学习的定义?(用ETP解释)
机器学习的要素有?(7个,用过程解释)
机器学习算法基本分类?(4个)
一、科学研究范式
科学的范式在不断演进,机器学习正处于第四、第五范式的交汇点:
| 范式 | 名称 | 核心方法 | 例子 |
|---|---|---|---|
| 第一范式 | 实验科学 | 描述记录自然现象,基于实验或经验的归纳 | 钻木取火、比萨斜塔实验 |
| 第二范式 | 理论科学 | Using models, generalizations,对自然现象建模、建模后进行数学推理 | 相对论、博弈论 |
| 第三范式 | 计算科学 | Simulating complex phenomena,计算机仿真模拟复杂实验 | 天气预报、核试验模拟 |
| 第四范式 | 数据科学 | Jim Gray 提出:把数据看成现实世界的传染病、观察行为蕴含的事实,数据驱动科学发现 | 大数据分析 |
| 第五范式 | 科学智能 | AI for Science,模型驱动与数据驱动深度融合 | AlphaFold |
核心要点第四范式(数据密集型科学发现)由图灵奖得主 Jim Gray 提出,是机器学习兴起的科学史背景:在实验观察、理论推导、计算仿真之后,数据本身成为科学发现的新途径。
鄂维南院士谈 AI for Science 的三大途径:处理数据的新方法(AI)、处理物理模型(基本原理)的新方法、以及模型驱动与数据驱动方法的深度融合。
二、课程大纲与考核
本课程主线:
绪论 → 线性回归 → 逻辑回归 → 神经网络 → 决策树 → 聚类考核方式:
| 项目 | 占比 |
|---|---|
| 考试 | 60% |
| 考勤 | 5% |
| 作业 | 20% |
| 实验 | 15% |
注意作业 + 实验 + 考勤共占 40%,比多数课程高。每次作业都是考点(如波士顿房价的梯度下降实现),要认真完成。
三、机器学习的定义
3.1 什么是学习
三种代表性观点,侧重点不同:
| 观点 | 代表人物 | 侧重点 |
|---|---|---|
| 学习是系统所作的适应性变化,使系统在下一次完成同样或类似任务时更为有效 | H. A. Simon (1975’ Turing) | 外部行为效果 |
| 学习是构造或修改对于所经历事物的表示 | R. S. Michalski | 内部过程 |
| 学习是知识的获取 | 专家系统研究者 | 知识工程的实用性角度 |
3.2 Tom Mitchell 的形式化定义(重点)
核心要点Tom Mitchell (1998) 的 Well-posed Learning Problem:
A computer program is said to learn from experience E with respect to some task T and some performance measure P, if its performance on T, as measured by P, improves with experience E.
程序从经验 E 中学习,针对任务 T,用性能度量 P 衡量,若在 T 上的表现随 E 增加而提升,则称该程序在学习。
记忆口诀:E/T/P 三要素。比如垃圾邮件分类:E = 历史邮件(带人工标注),T = 判断新邮件是否垃圾,P = 分类准确率。
3.3 维基百科解释
- 机器学习是近 20 多年兴起的多领域交叉学科,涉及概率论、统计学、逼近论、凸分析、算法复杂度理论等多门学科
- 理论主要是设计和分析让计算机可以自动”学习”的算法
- 算法从数据中自动分析获得规律,并利用规律对未知数据进行预测
- 因为涉及大量统计学理论,机器学习与统计推断联系尤为密切,也被称为统计学习理论
常见错误“机器学习就是人工智能”是常见误解。正确的关系:AI ⊃ 机器学习 ⊃ 表示学习 ⊃ 深度学习(示例:Autoencoders、Example-based neural network models 等)。深度学习只是机器学习中”用深层神经网络做表示学习”的子集。
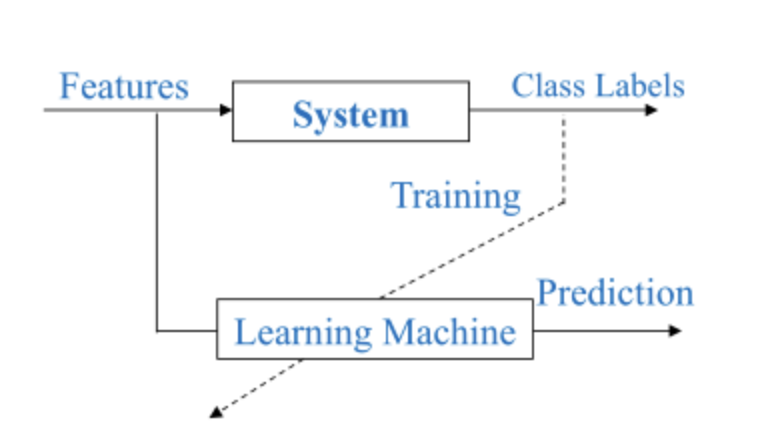
四、机器学习的要素
按 PPT 中 Machine Learning (ML) 的要素拆解:
- A system (unknown but existent):一个未知但真实存在的系统(我们要建模的对象)
- A set of observable features (input):一组可观测的特征(输入)
- An interested property (output):我们感兴趣的属性(输出)
- The Learning Machine (Model):学习机(模型)
- Predictions:预测
- Training Samples:训练样本
- The Learning Algorithm:学习算法
五、机器学习算法分类
- 监督学习:回归(连续输出)、分类(离散输出)
- 非监督学习:聚类、降维
- 半监督学习:少量标注 + 大量未标注
- 强化学习:动态规划、Sarsa、Q 学习、深度 Q 学习
核心要点判断监督/非监督的唯一标准:训练数据有没有标签。有标签(知道正确答案)→ 监督;无标签(只给数据找结构)→ 非监督。
典型场景:
- 监督:手写数字识别、鸢尾花分类、房价预测
- 非监督:鸡尾酒会问题(两个麦克风混出两人的声音,算法自行分离——独立成分分析 ICA)、用户聚类
- 强化学习:直升机特技飞行、AlphaGo 下棋(试错 + 奖励信号)
六、实例中值得记住的细节
6.1 Learning ≠ Memorization
分类器训练完后,对测试图片分类正确——而这张测试图片从未出现在训练数据中。
核心要点学习的本质是泛化(generalization):从训练样本中学到规律并应用于未见过的样本。只会背训练集的行为叫记忆(memorization),不叫学习。这是评估模型时必须用独立测试集的根本原因。
6.2 Iris 数据集
经典入门数据集:150 个样本,3 类鸢尾花(Setosa / Versicolor / Virginica),4 个属性(花萼长、花萼宽、花瓣长、花瓣宽)。监督学习中”分类”问题的标准练手集(http://archive.ics.uci.edu/ml/datasets/Iris)。
6.3 ChatGPT 的三步训练(RLHF)
- 监督微调 SFT:收集演示数据,训练监督策略
- 奖励模型:收集对比数据,训练奖励模型(标注员对输出排序,学习人类偏好)
- 强化学习 PPO:用奖励模型作奖励函数,用 PPO 算法优化策略
延伸理解这三步恰好对应本课程后面会学到的内容:SFT 是监督学习,奖励模型是回归问题(给输出打分),PPO 是强化学习。一条 ChatGPT 训练线串起了整门课的知识版图。
七、数学基础盘点(对照自查)
| 学科 | 需要掌握的知识点 |
|---|---|
| 微积分 | 导数、梯度、Hessian 矩阵、泰勒展开、凸函数、极值判定 |
| 线性代数 | 向量范数、特征值和特征向量、行列式、奇异值分解、正定矩阵、二次型、逆矩阵 |
| 概率论与统计 | 贝叶斯公式、数学期望、主要分布函数、协方差矩阵、最大似然估计 |
| 最优化方法 | 凸优化、梯度下降、牛顿法、Lagrange 乘子法、二次规划、坐标下降法、拟牛顿法 |
注意这张表就是本门课的”数学先修清单”。第一章线性回归立刻会用到:梯度(求偏导)、范数(正则化)、矩阵迹的性质(正规方程推导)。哪里生疏先补哪里。
八、工具与资源
- 工具:Matlab、Octave、Python、R
- 数据集站点:UCI Machine Learning Repository、Kaggle(数据建模和数据分析竞赛平台)、ImageNet(1400 万+ 张图像,21404 类)
- 竞赛:KDD Cup、阿里天池(https://tianchi.aliyun.com)
参考课程/教材:周志华《机器学习》(西瓜书)、李航《统计学习方法》、吴恩达《Machine Learning》(斯坦福公开课)